«А ви пробували вимкнути й увімкнути?» – мабуть, одна з найвідоміших фраз про IT. І так, доволі часто це спрацьовує. Програма зависла, служба перестала відповідати, сервер почав поводитися дивно – перезавантажили, і все повернулося до нормальної роботи. Тож, restart – цілком нормальний технічний інструмент, а не остання надія адміністратора.
Під час тривалої роботи система постійно щось робить: запускає й завершує процеси, використовує оперативну пам’ять, створює тимчасові файли, підтримує безліч з’єднань. Додамо сюди оновлення, частині яких для завершення встановлення потрібен restart. Перезавантаження коректно завершує старі процеси, запускає служби заново й дозволяє системі почати роботу з «чистого аркуша». Саме тому після нього багато дрібних проблем справді зникають.
Більше того, сервер зовсім не зобов’язаний працювати роками без жодного перезапуску. Планове перезавантаження після оновлень або під час технічного обслуговування – нормальна практика. Залежно від системи та режиму її роботи це може бути раз на кілька тижнів або, наприклад, під час щомісячного технічного вікна. Тому величезний uptime сам по собі ще не медаль за надійність: іноді за красивою цифрою ховається те, що стан сервера давно ніхто нормально не перевіряв.
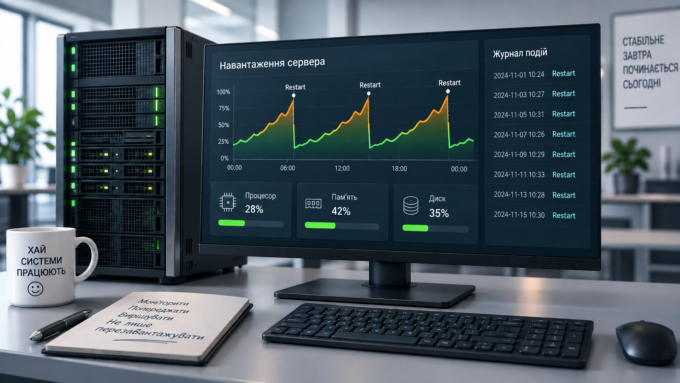
Зовсім інша справа, коли перезавантаження стає аварійною процедурою. Якщо в офісі вже є інструкція рівня «коли бухгалтерія зависне – подзвоніть адміну, він перезапустить сервер», а користуватися нею доводиться кожні кілька днів, варто шукати причину. Restart у такій ситуації прибирає симптом: звільняються ресурси, перезапускаються служби – і все знову працює. Але лише до наступного разу.
До речі, сама регулярність таких випадків може багато розповісти. Якщо після перезавантаження сервер нормально працює місяць – це одна історія. Якщо через дві доби знову починає гальмувати – треба дивитися, що відбувається з пам’яттю, процесами, службами, базами даних, диском і журналами подій за цей час. А якщо проблема повертається щовівторка о 10:30, сервер, здається, вже сам склав для IT-відділу графік діагностики.
Тож орієнтир доволі простий: плановий restart – нормальна частина обслуговування, а регулярний аварійний – привід шукати причину. Якщо перезавантажувати сервер доводиться через одну й ту саму проблему, варто хоча б фіксувати, коли вона виникає, що перестає працювати і через який час ситуація повторюється. Ці кілька деталей можуть значно спростити пошук причини й допомогти нарешті замінити «перезавантажили – працює» на «знайшли – виправили».
Зізнавайтеся: як часто Restart рятував ваш робочий день?
 Підпишіться на нашу інформаційну розсилку - отримуйте цікаві та корисні статті про ведення безпечного бізнесу, поради для керівників, пропозиції новітніх систем організації робочих процесів.